Result Detail – Clustering
Result Information
- Result ID
- 32
- Type
- Clustering
- Status
- completed
- Dataset ID
- 690
- Created
- 2026-09-21 02:12:45.307195
Clustering Result – Kmeans
- Method
- Kmeans
- Clusters (k)
- 3
- Silhouette score
- 0.1525 (higher = better separated)
- Rows clustered
- 59 (341 rows dropped for missing values)
- Feature columns
- PLOT, LAT, LONG, ENV_SOILNH4, ENV_SOILNO3, ENV_SOILP, ENV_SOILOC, ENV_SOILTN, ENV_SOILTC, ENV_PH, ENV_SOILCLAY, ENV_SOILSILT, ENV_SOILSAND, ENV_SOILMOIS, RC_SHOOTMASS, RC_WOODMASS, RC_LITTERMASS, RC_LITTERWMASS, PC_SHOOTMASS, PC_WOODMASS, PC_LITTERMASS, PC_LITTERWMASS, PC_ROOTMASS, PC_HEIGHT, GH_COUNT, ENV_AIRTEMP, COVER_RICHNESS_JUN, COVER_TOTAL_JUN, COVER_SHANNON_JUN, COVER_RICHNESS_JUL, COVER_TOTAL_JUL, COVER_SHANNON_JUL, COVER_RICHNESS_AUG, COVER_TOTAL_AUG, COVER_SHANNON_AUG, PASTURE_TOTALAREA, SUBPASTURE_TOTALAREA, PASTURE_FORESTAREA, PASTURE_WETLANDAREA, SUBPASTURE_FORESTAREA, SUBPASTURE_WETLANDAREA
Cluster sizes
Cluster 0: n=9
Cluster 1: n=35
Cluster 2: n=15
Per-cluster feature means
| Cluster | PLOT | LAT | LONG | ENV_SOILNH4 | ENV_SOILNO3 | ENV_SOILP | ENV_SOILOC | ENV_SOILTN | ENV_SOILTC | ENV_PH | ENV_SOILCLAY | ENV_SOILSILT | ENV_SOILSAND | ENV_SOILMOIS | RC_SHOOTMASS | RC_WOODMASS | RC_LITTERMASS | RC_LITTERWMASS | PC_SHOOTMASS | PC_WOODMASS | PC_LITTERMASS | PC_LITTERWMASS | PC_ROOTMASS | PC_HEIGHT | GH_COUNT | ENV_AIRTEMP | COVER_RICHNESS_JUN | COVER_TOTAL_JUN | COVER_SHANNON_JUN | COVER_RICHNESS_JUL | COVER_TOTAL_JUL | COVER_SHANNON_JUL | COVER_RICHNESS_AUG | COVER_TOTAL_AUG | COVER_SHANNON_AUG | PASTURE_TOTALAREA | SUBPASTURE_TOTALAREA | PASTURE_FORESTAREA | PASTURE_WETLANDAREA | SUBPASTURE_FORESTAREA | SUBPASTURE_WETLANDAREA |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 580.4 | 50.88 | -111.9 | 5.363 | 1.465 | 0.3329 | 0.8041 | 0.1063 | 1.192 | 7.386 | 3.343 | 7.39 | 89.26 | 3.105 | 16.89 | 0.1416 | 22.38 | 0 | 11.01 | 0.1181 | 22.29 | 0.3388 | 7.05 | 54.57 | 33.71 | 24.29 | 24.78 | 279.2 | 2.365 | 24.56 | 285.5 | 2.209 | 11.67 | 140.6 | 1.494 | 128.2 | 10.37 | 4.589 | 8.294 | 0.2519 | 0.7285 |
| 1 | 579.1 | 50.88 | -111.9 | 7.764 | 4.553 | 0.1553 | 0.7542 | 0.101 | 1.11 | 7.185 | 3.249 | 5.988 | 90.76 | 2.64 | 13.22 | 0.2014 | 19.01 | 0.3088 | 10.12 | 0.1836 | 22.49 | 0.2948 | 4.929 | 54.82 | 48.4 | 22.07 | 12.03 | 122.4 | 1.644 | 12.43 | 147.6 | 1.572 | 12.23 | 135.6 | 1.483 | 128.3 | 10.64 | 4.642 | 7.333 | 0.4134 | 0.645 |
| 2 | 661.9 | 50.86 | -111.9 | 15.15 | 12.97 | 0.3013 | 1.079 | 0.118 | 1.306 | 7.322 | 4.458 | 9.207 | 86.33 | 4.83 | 18.61 | 0.2566 | 30.27 | 0 | 15.63 | 0.245 | 23.93 | 0.3716 | 5.324 | 61.24 | 65.6 | 21.08 | 9.8 | 138.4 | 1.331 | 9.4 | 149.5 | 1.239 | 8.133 | 137.7 | 1.114 | 120.3 | 10.06 | 2.854 | 5.728 | 0.361 | 0.7053 |
Figures
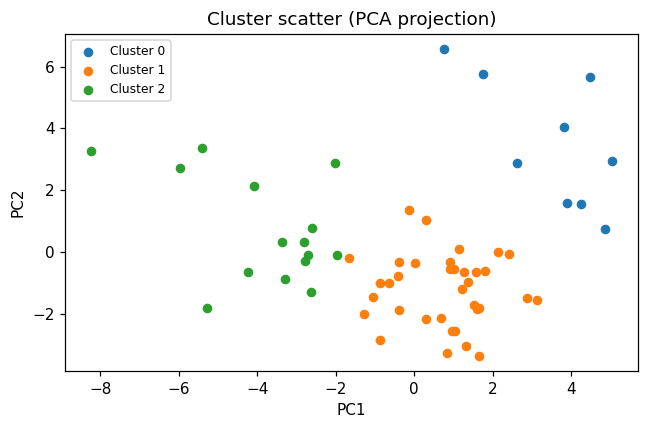
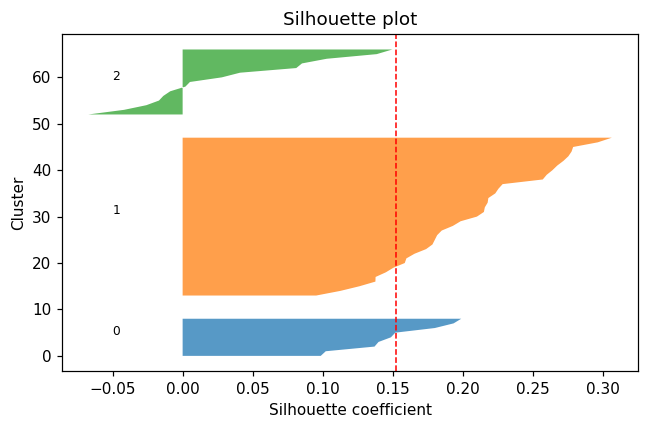
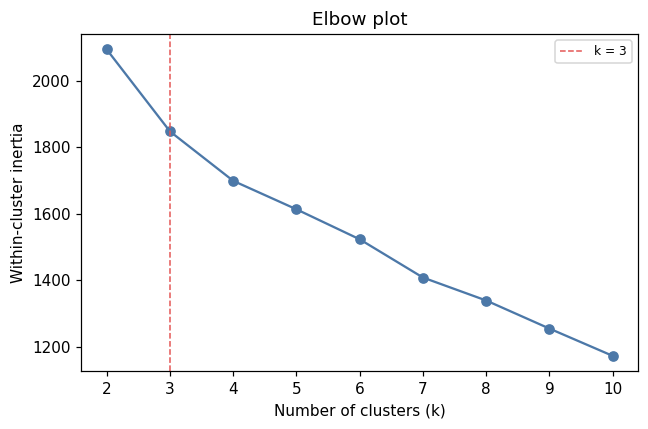
Derived Dataset — Ready for Downstream Analysis
The output of this run was saved as a new dataset, gallery — cat_g_field_data_plots.csv (clustered), which you can select in any downstream analysis (machine learning, statistical tests, further preprocessing, or feature selection).
Preview Dataset Open in Editor Run Another Analysis →Pathway Analysis (same dataset)
Method & Provenance
- Method
- Clustering — K-Means
- Method key
kmeans(result type:clustering, result #32)- Engine
- Python · scikit-learn v1.8.0
- Dataset(s)
- #690 gallery — cat_g_field_data_plots.csv
- Status
- completed
- Permanent link
- https://cat-g-omxpert.wishartlab.com/results/by-token/a038a07d3c7e4e02ab3ee272769ecd2c Bookmark or share this URL — it does not depend on your session.
- Created
- 2026-09-21 02:12:45.307195
Parameters used
| Parameter | Value |
|---|---|
cluster_method | kmeans |
feature_cols | PLOT, LAT, LONG, ENV_SOILNH4, ENV_SOILNO3, ENV_SOILP, ENV_SOILOC, ENV_SOILTN, ENV_SOILTC, ENV_PH, ENV_SOILCLAY, ENV_SOILSILT, ENV_SOILSAND, ENV_SOILMOIS, RC_SHOOTMASS, RC_WOODMASS, RC_LITTERMASS, RC_LITTERWMASS, PC_SHOOTMASS, PC_WOODMASS, PC_LITTERMASS, PC_LITTERWMASS, PC_ROOTMASS, PC_HEIGHT, GH_COUNT, ENV_AIRTEMP, COVER_RICHNESS_JUN, COVER_TOTAL_JUN, COVER_SHANNON_JUN, COVER_RICHNESS_JUL, COVER_TOTAL_JUL, COVER_SHANNON_JUL, COVER_RICHNESS_AUG, COVER_TOTAL_AUG, COVER_SHANNON_AUG, PASTURE_TOTALAREA, SUBPASTURE_TOTALAREA, PASTURE_FORESTAREA, PASTURE_WETLANDAREA, SUBPASTURE_FORESTAREA, SUBPASTURE_WETLANDAREA |
n_clusters | 3 |
Execution trace
Reconstructed from the parameters stored with this result — represents the Python/R calls the analysis service made.
from sklearn.cluster import KMeanslabels = KMeans(n_clusters=3, n_init=10, random_state=42).fit_predict(X)silhouette = sklearn.metrics.silhouette_score(X, labels)